Pour surveiller une application web et ses API, vérifiez que le service répond, que ses échanges fonctionnent et que les opérations utiles aboutissent. Une page d’accueil accessible ne prouve pas qu’un formulaire enregistre les demandes ou qu’une synchronisation se termine. Chaque alerte doit mener à une personne et à une action définies.
Ce guide propose une grille pour une PME et son prestataire. Le scénario est fictif ; les intervalles sont des exemples à adapter à l’impact d’une panne. Aucun test de disponibilité d’une application cliente n’a été réalisé pour cet article.
Partir du service rendu à l’entreprise
Dressez une liste courte des parcours dont l’interruption bloque le travail : recevoir une demande, consulter un dossier, enregistrer une commande ou transmettre une information. Pour chaque parcours, identifiez l’application, les services tiers et le responsable.
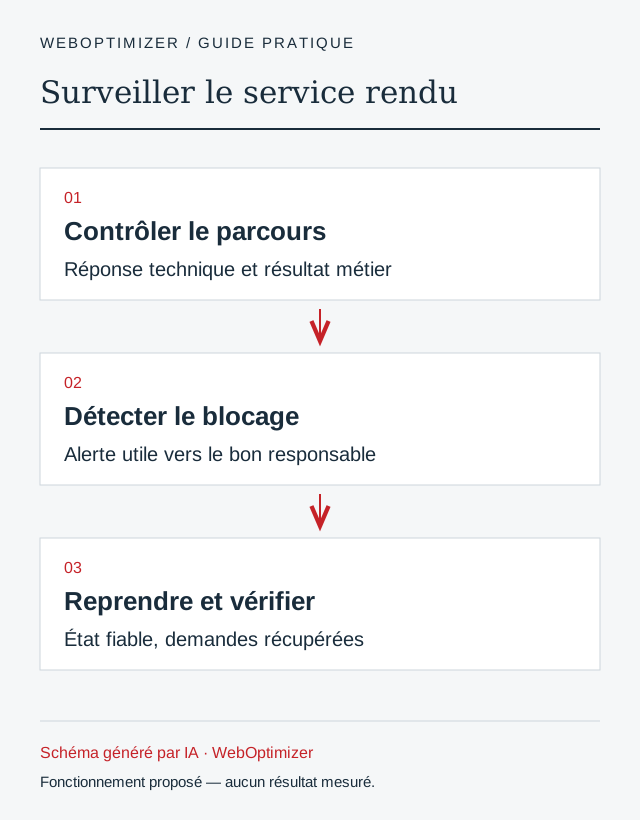
Un contrôle peut avoir trois niveaux. Le serveur répond-il ? L’application accède-t-elle aux ressources nécessaires ? L’opération métier arrive-t-elle à son terme ? Ces observations se complètent, sans être interchangeables.
Le chapitre Monitoring Distributed Systems de Google SRE distingue l’observation du comportement extérieur et celle des mécanismes internes. Il souligne aussi le besoin d’alertes utiles à leur destinataire. Une PME peut reprendre ces principes sans reproduire l’infrastructure de Google.
Les contrôles à combiner
La grille suivante sert à discuter avec l’équipe qui maintient le service. Il faut pouvoir expliquer ce que chaque contrôle prouve et ce qu’il laisse de côté.
| Contrôle | Ce qu’il peut montrer | Ce qu’il ne prouve pas seul |
|---|---|---|
| Accès HTTPS depuis l’extérieur | Le point contrôlé est joignable et son certificat accepté | Tous les parcours fonctionnent |
| Réponse attendue d’une route | Le contenu ou statut prévu est présent | Une écriture métier a réussi |
| Échange avec une API | Une opération précise répond dans les conditions du test | Tous les comptes et toutes les données sont valides |
| Ancienneté des demandes en attente | Un traitement prend du retard | La cause exacte du retard |
| Dernière exécution réussie | Une tâche planifiée a récemment terminé | Les données attendues étaient complètes |
| Contrôle d’un résultat métier | Une demande ou un document est arrivé à destination | Le traitement est correct pour tous les cas |
Le code HTTP fait partie du contrôle. Vérifiez aussi le résultat attendu : un serveur peut renvoyer une page de connexion à la place de la ressource demandée. Un test doit préciser s’il utilise un compte et quelles permissions ce compte possède.
Exemple fictif : le site fonctionne, les demandes n’arrivent plus
Imaginons un formulaire relié à un CRM. Le site répond normalement, mais l’accès de l’intégration au CRM a été retiré. Les visiteurs continuent d’envoyer des demandes, qui attendent dans une file de traitement.
Le contrôle de la page d’accueil reste au vert. Un contrôle des erreurs d’accès peut détecter le refus. Le suivi de l’âge de la plus ancienne demande en attente peut montrer l’effet sur le traitement. Une vérification du résultat dans le CRM permet de confirmer le retour au fonctionnement attendu.
C’est pourquoi le parcours formulaire vers CRM doit conserver des identifiants et des états. Sans ces repères, il devient difficile de savoir quelles demandes ont été reçues, créées, bloquées ou transmises deux fois.
Tester un parcours sans créer de faux dossiers clients
Un contrôle synthétique reproduit une action avec des données de test. Il peut vérifier une étape de bout en bout, mais il faut maîtriser ses effets : courriel envoyé, fiche créée, stock modifié ou document facturé.
Utilisez si possible un environnement de test ou un compte et un parcours explicitement prévus à cet effet. Marquez les dossiers synthétiques, limitez leurs droits et définissez leur nettoyage. Un contrôle de lecture peut suffire pour certaines dépendances ; une écriture nécessite un scénario convenu avec le responsable métier.
Ne lancez pas un paiement, une commande ou un message client pour vérifier discrètement une chaîne réelle. La surveillance doit être conçue avec les mêmes règles d’autorisation que l’application.
Définir un délai utile avant de régler les alertes
Demandez combien de temps l’entreprise peut attendre avant d’agir. Une synchronisation nocturne n’a pas la même urgence qu’un service utilisé pendant un rendez-vous. L’intervalle de contrôle doit être cohérent avec le délai de détection accepté et les limites d’usage des API.
Exemple fictif : si un retard de trente minutes devient problématique pendant les heures ouvrées, une vérification quotidienne ne répond pas au besoin. Tester plus souvent peut réduire le délai de détection, tout en augmentant les appels et le bruit. Il faut ensuite compter le temps de réception de l’alerte et le temps d’intervention.
Un contrôle toutes les cinq minutes ne garantit donc pas un rétablissement en cinq minutes. Définissez séparément la fréquence de vérification, les horaires de prise en charge et les engagements éventuellement convenus avec le prestataire.
Une alerte doit expliquer l’action attendue
Un message utile indique le service concerné, l’heure, le symptôme observé, l’impact connu et le lien vers la procédure. Une référence d’exécution suffit souvent à retrouver le détail ; les secrets et documents clients n’ont pas leur place dans une notification.
Distinguez les incidents à traiter immédiatement des anomalies qui peuvent attendre une revue. Regroupez les répétitions d’un même incident et prévoyez un message de retour à la normale. Le nombre d’alertes n’est pas une mesure de qualité de la surveillance.
Dans n8n, un workflow d’erreur peut déclencher une notification lorsqu’une exécution échoue. Il faut aussi surveiller les absences d’exécution ou de résultat : un déclencheur qui ne démarre jamais peut ne produire aucune erreur d’exécution à signaler.
Surveiller les dépendances et les changements
Une application web dépend souvent d’un domaine, de certificats, de comptes, d’un hébergement et d’API tierces. Tenez un inventaire court avec le propriétaire de chaque accès et les annonces de changement à suivre. Un renouvellement de certificat ou une rotation d’accès doit pouvoir être vérifié sans attendre une plainte d’utilisateur.
Pour les notifications techniques envoyées par un fournisseur, examinez ses garanties de livraison. La documentation des webhooks Stripe décrit notamment des situations de répétition et d’ordre de livraison non garanti. Cet exemple rappelle qu’une intégration doit suivre ses propres règles de réception et de reprise ; il ne décrit pas les garanties de toutes les API.
Le suivi technique ne remplace pas l’entretien : mises à jour testées, sauvegardes et contrôle des accès restent nécessaires. Le dossier sur la maintenance régulière d’un site web complète cette partie.
Préparer la reprise avant l’incident
La procédure doit dire comment arrêter les écritures, préserver les demandes et déterminer le dernier état fiable. Après correction, reprendre toute la file depuis le début peut répéter des opérations déjà réalisées.
Faites d’abord l’inventaire des dossiers bloqués et des résultats incertains. Vérifiez ceux dont l’action a pu aboutir malgré une réponse perdue. Reprenez selon les identifiants conservés et les garanties de chaque outil. Si l’état ne peut pas être établi, prévoyez un examen manuel.
La reprise est terminée lorsque les contrôles techniques sont satisfaisants et que le retard métier est traité ou explicitement pris en charge. Une alerte disparue ne suffit pas à prouver que toutes les demandes ont été récupérées.
La fiche de surveillance à convenir avec votre prestataire
- Service utile : parcours métier à protéger et conséquences d’un arrêt.
- Contrôle : action testée, résultat attendu et limites.
- Fréquence : intervalle, horaires et délai de détection accepté.
- Alerte : destinataire, remplaçant et canal réellement surveillé.
- Procédure : diagnostic initial, arrêt, préservation des données et reprise.
- Vérification : test d’échec contrôlé et preuve de retour au fonctionnement.
Commencez par les parcours les plus importants, puis élargissez selon les incidents observés. Pour une nouvelle automatisation, la fiche de choix du premier processus permet de prévoir ce suivi dès le cadrage. L’IA peut intervenir sur un événement détecté, mais un contrôle technique répétitif peut s’exécuter sans appel au modèle.
Pour présenter un problème de surveillance ou de maintenance, indiquez le service, le symptôme et le moment où il apparaît. Une description suffit pour commencer ; ne joignez aucun secret d’accès.